[NDC 26] 并不轻松,枫之谷世界自主大语言模型‘丹枫’开发记
[NDC 26] 쉽지 않았습니다, 메이플 월드 자체 LLM ‘단풍’ 개발기
2026.06.16 16:23 UTC+9

人工智能概要
NEXON在NDC 26上公开了枫之谷世界专属LLM模型Danpoong的开发幕后故事。团队克服训练样本不足的难关,通过CPT、SFT和GRPO三大阶段提升了代码生成的准确度。未来团队将基于用户实际反馈持续优化,探索更高效的AI应用策略。
近期,UGC(User Generated Content)备受瞩目。得益于能够让非开发者用户亲自创作所需内容的魅力,以Roblox为首,Fortnite、原神等各种作品纷纷引入了UGC内容。NEXON也顺应这一趋势,于2022年推出了枫之谷世界,此后Mapleland、风之国:Classic、Maple Planet等多个内容引发热议,成功在市场上站稳了脚跟。
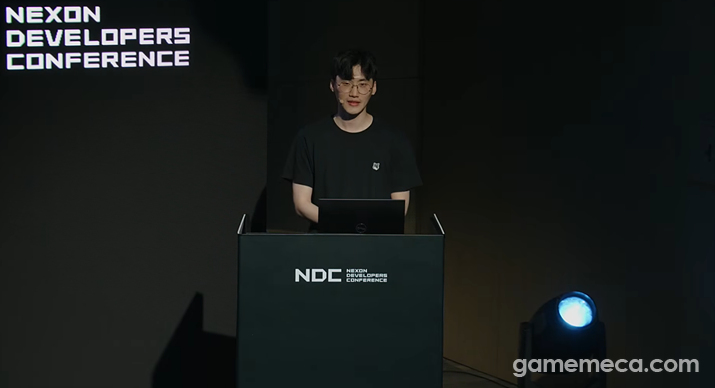
不过,枫之谷世界的开发并非一开始就一帆风顺。特别是枫之谷世界使用的是自有脚本语言“mlua”,因此很难通过通用AI代码生成模型来进行开发。为此,制作团队打造了专属LLM模型“Danpoong”并延续至今。在16日举行的NDC 26上,我们得以详细了解“Danpoong”的开发秘事。NEXON枫之谷世界Future Unit的开发者Han Ji-sung出席了本次演讲。
如前所述,枫之谷世界运用了名为“mlua”的独家脚本语言。除了常规结构外,它还使用了数百个自有API,因此门槛极高。正因如此,ChatGPT、Gemini等通用AI很难直接应用,构建专用LLM模型便成了不可避免的选择。
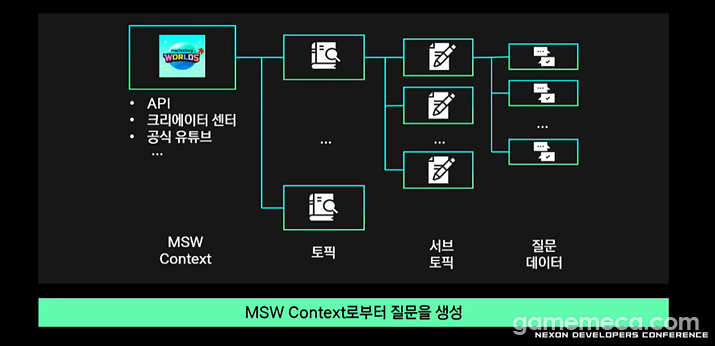
打造专用模型面临的最大难关是缺乏训练样本。对此,开发团队以官方创作者中心和YouTube等外部大型模型为基础,构思出了大量生成虚拟问题并进行训练的方式。通过该源码生成主题后,再将其拆分为多个子主题,并转换为问题数据进行结构化训练。经由各个阶段最终完成的代码,再次通过自动化语法检查器和去重流程,蜕变成了高质量的训练素材。
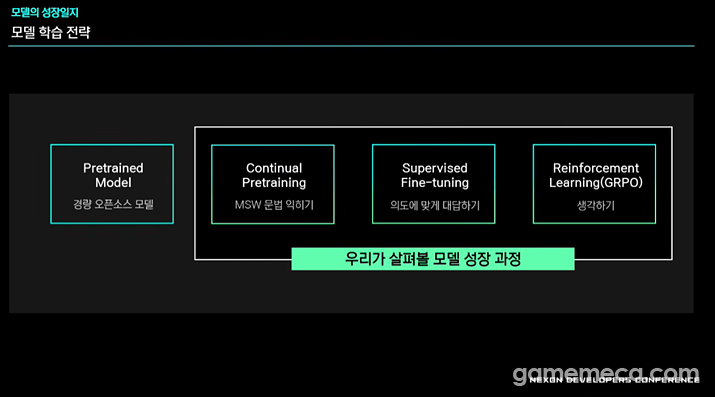
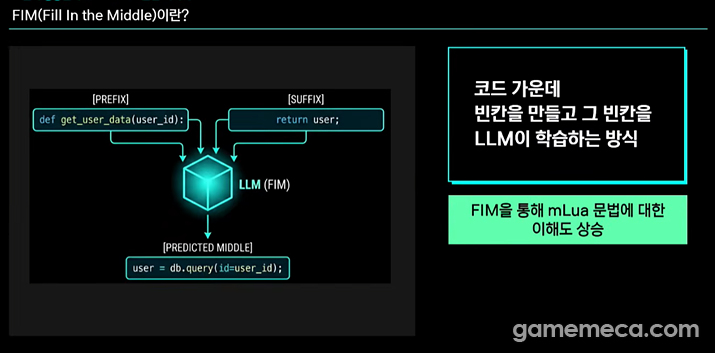
Han Ji-sung将通过这种方式打造的“Danpoong”成长过程概括为CPT(Continual Pretraining)、SFT(Supervised Fine-tuning)、GRPO(Reinforcement Learning)三大阶段。首先,CPT是熟悉基础枫之谷语法过程。通过应用旨在保持原有模型推理能力的数学数据,以及填补“mlua”脚本中间空白的技术,注入了领域知识与语法。
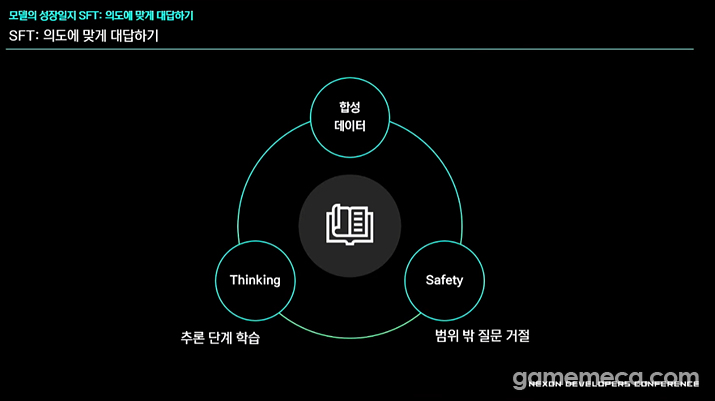
其次,SFT是使其按照意图进行回答的阶段。为此,团队基于合成数据、思维(Thinking)数据、安全性(Safety)数据等三大要素进行了训练。结果显示,答非所问的情况明显减少,并且能够同时生成自然的键连接与主要干货。
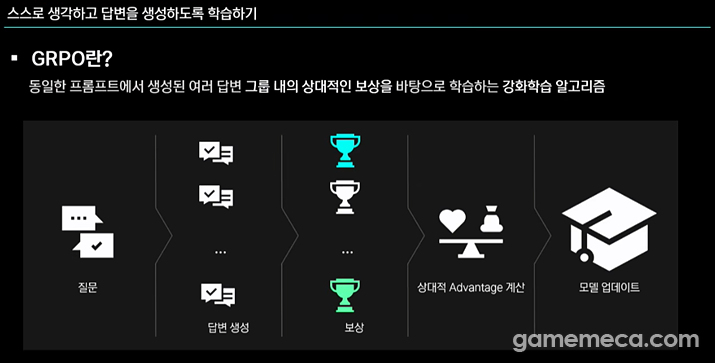
不过,在此过程中也出现了幻觉现象,即面对与枫之谷世界无关的问题时也会给出毫无根据的回答。为了防止这一点,团队推进了最后阶段——GRPO。这是一种根据回答准确度实施差异化奖励的强化学习技术,具有根据奖励带来的优势计算并给出更好回答的功能。通过该功能,“Danpoong”具备了通过思考过程自行拒绝回答的能力,从而能够给出更准确的回答。
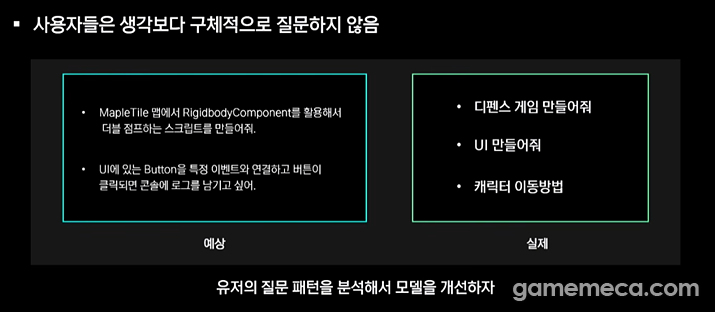
尽管经过了如此细致的训练阶段,但在正式上线后不久,由于AI安全标准设置得过高,甚至连正常的编程提问也被拦截,从而产生了副作用。此外,用户倾向于抛出非常简单简短的词汇来提问,而不是具体描述情况。例如,“我想把UI里的按钮连接到特定事件并记录日志”的问题被缩减成了“帮我做个UI”。
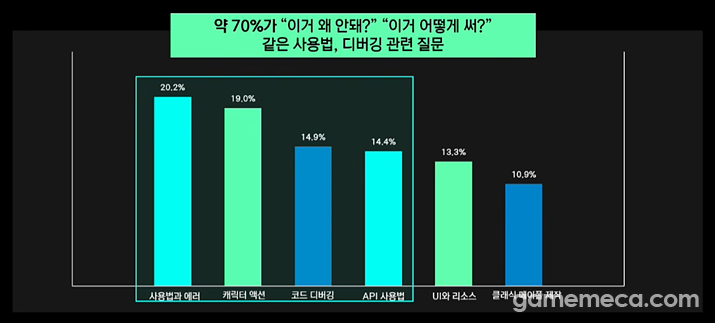
对此,开发团队发现用户的相当一部分咨询都集中在“使用方法与错误”、“角色动作”、“代码调试”等基础用法上,并全面修改了训练素材与奖励机制。结果,即便是面对简短且模糊的问题,它也能推测出编写者的原本意图,并给出正确的解决方案。
最后,Han Ji-sung表示:“通过这一过程,我们也学到了很多。”首先,由于很难判断LLM是否实际执行,因此需要一个能够进行验证的环境。此外,由于工作空间不足,只能实现以基础语法脚本为主的回答,对于帮助用户而言仍有诸多漏洞。除此之外,由于只能使用有限的资源,这也让团队切实体会到了高效实验策略的必要性。
최근 UGC(User Generated Content)가 주목 받고 있다. 개발자가 아닌 유저가 직접 원하는 콘텐츠를 만들 수 있다는 매력 덕분에, 로블록스를 필두로 포트나이트, 원신 등 다양한 작품이 UGC 콘텐츠를 도입하는 추세다. 넥슨 역시 이러한 흐름에 맞춰 2022년 메이플스토리 월드를 선보였고, 이후 메이플랜드, 바람의 나라 클래식, 메이플플래닛 등 여러 콘텐츠가 화제를 모으며 시장에 당당히 자리잡았다.
하지만 메이플스토리 월드가 처음부터 순탄하게 개발됐던 것은 아니다. 특히 메이플스토리 월드는 자체 스크립트 언어인 ‘mlua’를 사용하는 만큼, 범용 AI 코드 생성 모델로는 개발이 어려웠다. 때문에 제작진은 자체 LLM 모델 ‘단풍’을 만들어 개발을 이어오고 있는데, 16일 진행된 NDC 26에서 ‘단풍’ 개발 비화에 대해 자세한 이야기를 들을 수 있었다. 강연에는 넥슨 메이플스토리 월드 퓨처유닛 한지성 개발자가 자리했다.
메이플스토리 월드는 앞서 언급했듯 ‘mlua’라는 독자적인 스크립트 언어를 활용한다. 이는 일반적인 구조에 더해, 수백 개의 자체 API를 사용하기 때문에 접근하기 매우 까다롭다. 그로 인해 챗GPT, 제미나이 등 범용적인 AI들은 적용이 다소 어려웠고, 전용 LLM 모델 구축이 불가피해졌다.
전용 모델을 만들기 위한 가장 큰 난관은 학습용 표본의 부재였다. 이에 개발진은 공식 크리에이터 센터와 유튜브 등 외부 거대 모델을 기반으로, 가상의 질문을 대량으로 만들어내 학습하는 방식을 고안했다. 해당 소스를 통해 토픽을 만들면 그것을 다시 여러 개의 서브 토픽으로 나누고, 이를 질문 데이터로 변환해 학습하는 구조다. 각 단계를 거쳐 완성된 코드는 다시 자동화된 문법 검사기와 중복 제거 절차를 통해 고품질의 학습 자료로 탈바꿈했다.
한지성 개발자는 이렇게 만들어진 ‘단풍’의 성장 과정을 CPT(Continual Pretraining), SFT(Supervised Fine-tuning), GRPO(Reinforcement Learning) 등 크게 세 단계로 요약했다. 먼저 CPT는 기본적인 메이플스토리 월드 문법을 익히기 위한 과정이다. 기존 모델의 추론 능력을 유지하기 위한 수학 데이터와 함께, ‘mlua’ 스크립트의 중간 빈칸을 채우는 기법을 적용하는 과정을 거쳐 도메인 지식과 문법을 주입했다.
두 번째로 SFT는 의도에 맞게 대답하도록 만드는 단계다. 이를 위해 합성 데이터, 사고(Thinking) 데이터, 안전성(Safety) 데이터 등 세 가지 요소를 기반으로 학습을 진행했다. 그 결과 질문에 상관없는 답변을 하는 경우가 눈에 띄게 줄었으며, 자연스러운 키 연결과 주요 팁도 함께 생성됐다.
다만 이 과정에서 메이플스토리 월드와 관련이 없는 질문에도 근거 없는 답변을 내놓는 할루시네이션 현상이 발생했다. 이를 방지하기 위해 진행된 것이 마지막 단계인 GRPO다. 이는 답변 정확도에 따라 보상을 차등 지급하는 강화학습 기법으로, 보상에 따른 이점을 계산해 더 나은 답변을 내놓도록 하는 기능이다. 이를 통해 ‘단풍’은 생각하는 과정을 통해 스스로 답변을 거절하는 기능이 생겼고, 더욱 정확한 답변이 가능해졌다.
이처럼 세밀한 학습 과정을 거쳤음에도, 실제 서비스가 시작된 직후에는 AI 안전 기준이 지나치게 높게 설정되어 정상적인 프로그래밍 질문마저 차단하는 부작용이 나타났다. 또한 유저들은 구체적인 상황 설명보다는 아주 단순하고 짧은 단어로 질문을 던지는 경향이 강했다. 예를 들어 ‘UI에 있는 버튼을 특정 이벤트와 연결하고 로그를 남기고 싶어’라는 질문이 ‘UI 만들어줘’로 축약되는 식이다.
이에 개발진은 유저 질의 상당수가 ‘사용법과 에러’, ‘캐릭터 액션’, ‘코드 디버깅’ 등 기초적인 사용법에 집중되어 있다는 점을 파악하고, 학습 자료와 보상 체계를 전면 수정했다. 그 결과 짧고 모호한 질문에도 작성자의 원래 의도를 유추하여 올바른 해결책을 제시할 수 있게 됐다.
마지막으로 한지성 개발자는 “이러한 과정 덕분에 배운 점도 많았다”고 전했다. 먼저 LLM 실제 실행 여부를 판단하기 어려워, 검증이 가능한 환경이 필요하다는 사실을 알게 됐다. 또한 워크스페이스 부족으로 인해 기본적인 문법 스크립트 위주 답변밖에 구현할 수 없어, 유저에게 도움이 되기에는 허점도 많았다. 그 외에도 제한된 자원을 사용할 수 밖에 없어, 효율적인 실험 전략의 필요성을 실감했다.
这则新闻由人工智能翻译。

我将以一篇好文章来问候你。 niro201@gamemeca.com
推荐新闻
媒体合作伙伴

GAMEMECA社交媒体